日々の技術の進歩を見ていると、AIによる画像生成の進化スピードには本当に驚かされるばかりです。テキストからパッと絵や写真のようなビジュアルが作れること自体、少し前なら魔法のようでしたが、いまや日常的なツールとして定着しつつあります。
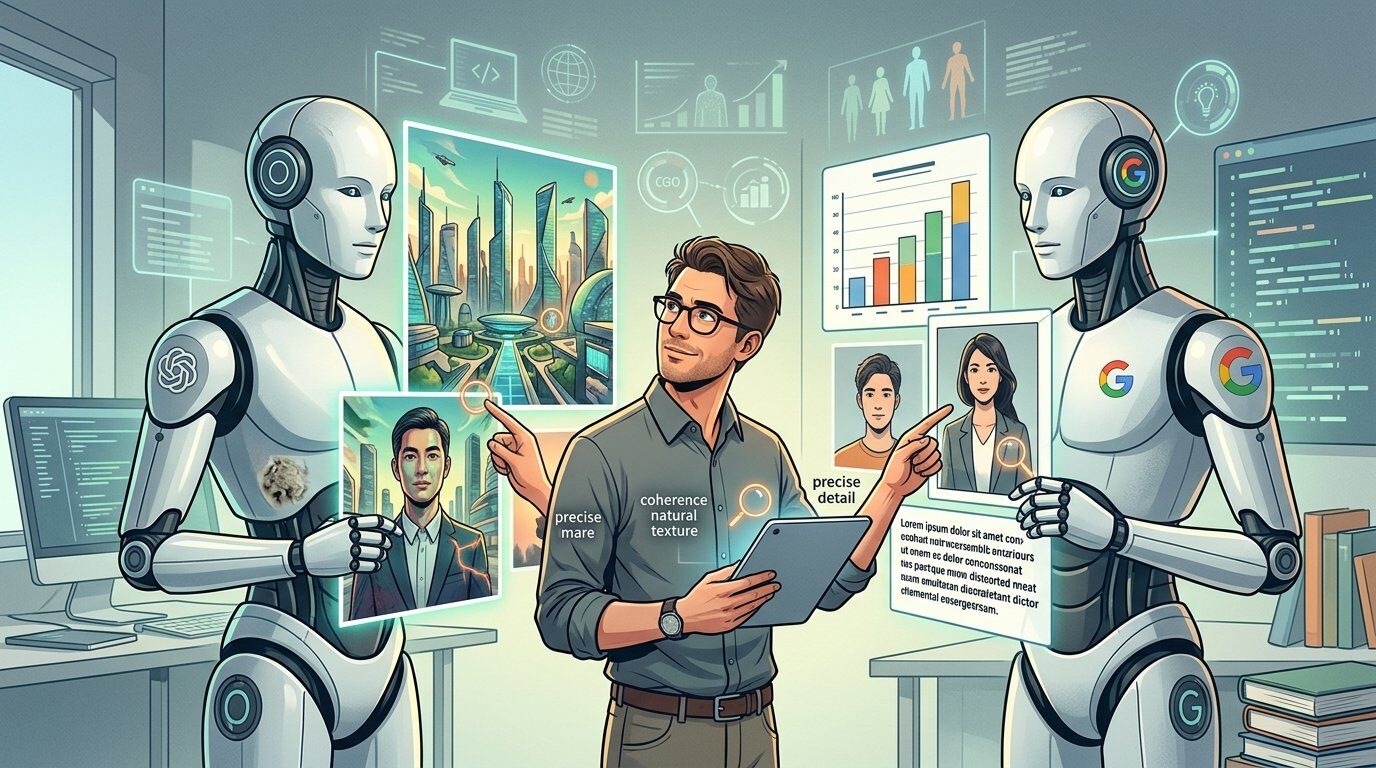
生成AIの分野といえば、現在はやはりOpenAIとGoogleの2社が中心的な存在として注目を集めています。ただ、個人的な印象としては、ここしばらくのところはOpenAIの圧勝という空気が続いていたように感じていました。クオリティや使い勝手の面で一歩先を行くOpenAIに対して、他社がどこまで追いつけるのかという構図を意識していた方も多いのではないでしょうか。
目次
Googleの新しい発表に見る「実用性」へのアプローチ
そんななか、Google側からも画像生成モデルのアップデートに関する話題が出てきています。たとえば「Nano Banana 2.1」といった新しいモデルの発表では、解像度や画質の向上だけでなく、キャラクターの一貫性や編集機能、さらには図表やテキストの描写精度を高める試みが盛り込まれているようです。
これまでの画像生成AIは「指示通りに1枚のすごい絵を出す」ことには長けていても、以下のような細かな調整には弱さがありました。
- 同じ人物を別の構図やポーズで破綻なく登場させること
- 画像内に入れたい文字やインフォグラフィックを正確に描くこと
- 生成した画像の特定部分だけを自然に修正すること
今回のGoogleの動きなどを見ていると、単に綺麗な画像を一発で出力する段階から、「思い通りにコントロールして編集できるか」という実用的な段階へシフトしようとしている姿勢が伝わってきます。
見抜かれてしまう「AIっぽさ」という高い壁
技術がどれほど進化してベンチマークのスコアが上がったとしても、日常の中で画像や文章を見ていると、「ハッキリ言って、AIっぽさを人間が見抜けてしまう」という場面がまだまだ多いのが現実です。
どこかツルッとしすぎた質感や、構図の不自然な癖、あるいは文章であれば独特の言い回しやリズムの違和感など、直感的に「あ、これはAIが作ったものだな」と気づいてしまう瞬間があります。どれだけ解像度が高くなっても、人間の観察眼は意外とシビアです。
資料などを確認してみても、モデルの制限事項として「細かな文字や長い文章の描写の乱れ」「左右などの空間的な位置関係の混乱」「キャラクターの一貫性が完璧とは限らない点」などが挙げられています。開発元自身が改善の余地を認めている通り、細部のリアリティや自然さを徹底的に突き詰めるには、まだいくつかの壁が存在しているようです。
「仕事でしっかりと活用できる」とはどういうことか
趣味で楽しんだり、アイデア出しのラフ案として眺めたりする程度であれば、多少の違和感があっても十分に役立ちますし、面白いツールです。
ですが、これが「仕事の現場でしっかりと活用する」となると、求められる基準は一気に跳ね上がります。
- クライアントや受け手が「違和感」を抱かない自然さがあること
- 製品やブランドのキャラクター設定にブレが生じないこと
- 細部の修正指示に対して、意図通りに正確に対応できること
ビジネスの成果物として世に出す以上、受け手に「AIで作った手抜きだな」と見抜かれてしまったり、不自然さに気を取られてメッセージが伝わらなくなってしまっては本末転倒です。そうした「AI特有の違和感」を人間が意識せずに受け入れられるレベルをクリアして初めて、本当の意味で仕事の現場に定着していくのだろうなと感じます。
ツールの進化を見守りながら
OpenAIの独走に見えた状況から、Googleをはじめとする各社が編集のしやすさや実用性を意識したアップデートを重ねていくことで、競争はさらに面白くなっていくはずです。
「人間が見抜けない自然さ」と「思い通りのコントロール性」というハードルを、技術がいつ、どのように飛び越えていくのか。日々の進化に期待しながら、仕事で当たり前に使える日が来るプロセスをじっくり見ていきたいところです。